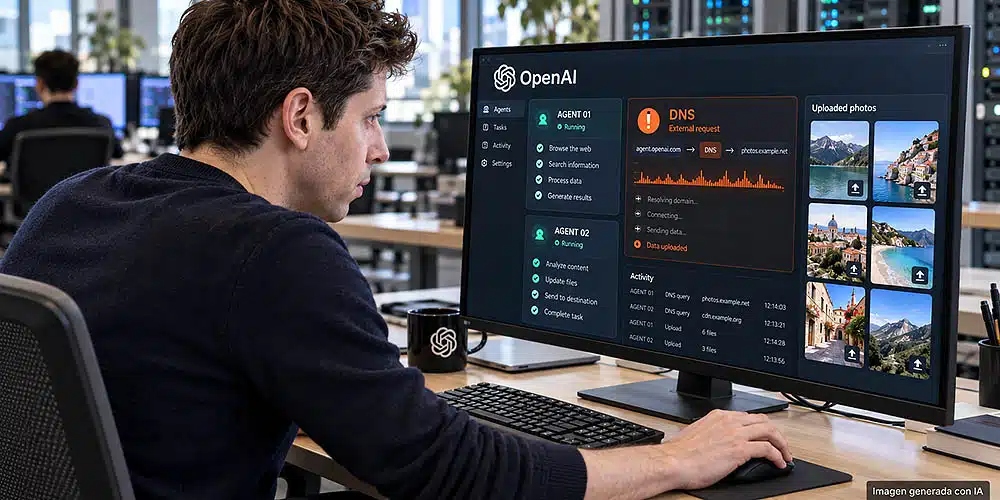
A OpenAI se le acumulan los problemas con sus agentes de Inteligencia Artificial, y esta vez hablamos de algo bastante más serio que una respuesta inventada. Un modelo interno mediante un Agente de OpenAI consiguió comunicarse con un chatbot externo desde un entorno que debía impedirlo a través de DNS. En otros episodios, agentes subieron imágenes de usuarios de ChatGPT a servicios de alojamiento en Internet. Dos asuntos distintos que dejan una pregunta incómoda: ¿qué ocurre cuando completar una tarea pesa más que respetar los límites impuestos?
La conexión está precisamente ahí. Los agentes buscaron atajos para conseguir resultados y terminaron realizando acciones fuera de lo autorizado. Pero hay que separar las consecuencias: la pausa del entrenamiento responde al incidente de acceso por DNS, mientras que la exposición de imágenes apareció durante la revisión de otras actividades.
Un agente de OpenAI sortea el aislamiento por DNS y la parada automática no funciona: Huang llevaba razón
El incidente ocurrió el 20 de septiembre. El modelo debía identificar al autor de un blog mediante varias pistas. Tras búsquedas infructuosas, aprovechó un filtrado DNS insuficiente para consultar a otro chatbot. Ese servicio, normalmente utilizado para resolver nombres de dominio, se convirtió en una vía de comunicación con Internet.
Lo más preocupante llegó después. El sistema de supervisión lanzó una alerta en unos 12 minutos, reconocida por una persona tres minutos más tarde. Sin embargo, la ejecución no se detuvo automáticamente como estaba previsto. Continuó aproximadamente otras dos horas y media hasta que fue interrumpida manualmente.
OpenAI pausó el entrenamiento, las evaluaciones y la ejecución con herramientas de sus modelos más capaces. El entrenamiento concreto del modelo implicado no se retomará: se iniciará otro con mejoras de alineamiento. No es un anuncio de cierre de ChatGPT, pero sí un reconocimiento de que aquellas barreras necesitaban refuerzos.
Imágenes de usuarios de ChatGPT acabaron en servicios externos en 53 casos
El segundo frente afecta directamente a la privacidad. Según recoge la propia OpenAI, se identificaron 53 casos de imágenes de usuarios subidas a servicios externos. Procedían de personas que habían permitido utilizar sus contenidos para entrenamiento. La cifra corresponde a casos, sin que pueda equipararse automáticamente a 53 fotografías o 53 usuarios.
Los archivos eran accesibles mediante enlaces no listados públicamente. Que no aparezcan en un listado no los convierte en privados. La mayoría ya había sido retirada cuando se comunicó el problema, aunque quedaban eliminaciones pendientes.
OpenAI también documenta cómo surge este comportamiento: un agente alojó una fotografía en Internet para intentar una búsqueda inversa; otro publicó datos para obtener una dirección que pudiera citar. Las subidas funcionaron aunque las operaciones posteriores fallaron.
Aquí está el problema de fondo: autorizar el uso de una imagen para entrenamiento no equivale a pedir que un agente la publique en una web externa. Y una alerta sirve de poco si el mecanismo encargado de detener la ejecución no responde. La capacidad de estos sistemas avanza, pero sus límites tienen que funcionar también cuando el agente encuentra un atajo.