Arm ha anunciado una renovación de su catálogo que abarca desde los móviles hasta los servidores. Esto implica nuevas CPU C2-Ultra y C2-Pro, una GPU Mali G2-Ultra NX con aceleración para gráficos neuronales, y Neoverse CSS N4, que permitirá desarrollar procesadores de hasta 128 núcleos por die. Todo ello acompañado de software para aprovechar el hardware, con la Inteligencia Artificial como principal argumento de esta ofensiva. En definitiva, Arm quiere reforzarse en sectores donde compiten Intel, AMD, Qualcomm, Apple, MediaTek y NVIDIA, aunque varios de ellos también son sus socios. Propuestas concretas, hardware y software al unísono, pero… ¿Puede competir realmente?
Antes de entrar en detalles, toca aclarar qué está ofreciendo Arm, al menos de cara a los neófitos, porque esto va a ser largo. CSS significa Compute Subsystems: conjuntos de diseños integrados y validados que sus socios pueden adaptar para crear sus chips. Es decir, hablamos de las bases sobre las que otros fabricantes desarrollarán sus productos, y eso es precisamente lo interesante. Estos anuncios de CSS no son lanzamientos de procesadores comerciales terminados, aunque Arm también tenga una estrategia de silicio propio en servidores.
Arm sienta las bases de sus próximos chips móviles con CSS for Mobile 2 y las CPU C2
Lo interesante es que la compañía no solamente quiere avanzar con sus diseños de CPU, sino también mejorar cómo trabajan conjuntamente los distintos componentes. Aquí encontramos dos plataformas diferenciadas para entender el despliegue: CSS for Mobile 2 para móviles y Neoverse CSS N4 para infraestructura y servidores.
Comenzando por los móviles, CSS for Mobile 2 combina las CPU C2, la nueva GPU Mali y la interconexión SI L2. Arm muestra una configuración de ejemplo con dos C2-Ultra y seis C2-Pro, acompañados de dos bloques SME2 dentro del clúster, sin que ello obligue a todos sus socios a utilizar esa distribución. Según sus cifras, esta generación ofrece un 15% más de rendimiento monohilo, navegación web un 15% más rápida y mejoras del 12% en apertura de aplicaciones y rendimiento multihilo.
Ahora bien, la flexibilidad va más allá de ese diseño de ocho núcleos. La topología admite Ultra, Pro y Nano, con frecuencias independientes para los tres tipos. Arm ilustra configuraciones que van desde dos Nano hasta dos Ultra y seis Pro, pasando por distintas combinaciones intermedias. Son ejemplos para cubrir diferentes niveles de precio, rendimiento y consumo, no una lista de SoC comerciales anunciados. Tampoco hay que interpretar esa diapositiva como la confirmación de un nuevo núcleo llamado C2-Nano.
La configuración más pequeña aparece como 25 veces menor que la de gama alta, mientras que esta última ofrece hasta 17 veces su rendimiento, según Arm. Son comparaciones entre extremos de configuración, no mejoras generacionales. Además, la variante de dos Nano se muestra sin SME2, mientras que las restantes ilustran opciones habilitadas para esta aceleración.
En cuanto a la memoria interna, las CPU cuentan con caché L2 privada y L3 compartida mediante la DSU, o DynamIQ Shared Unit. Con ello, Arm busca mantener más datos cerca de los núcleos, reducir el tráfico hacia la caché de sistema y la DRAM, y mejorar tanto las latencias como el consumo y el rendimiento sostenido. La plataforma de referencia aumenta, además, la L2 de los Ultra de 2 a 3 MB.
El 15% más de rendimiento no es un 15% más de IPC
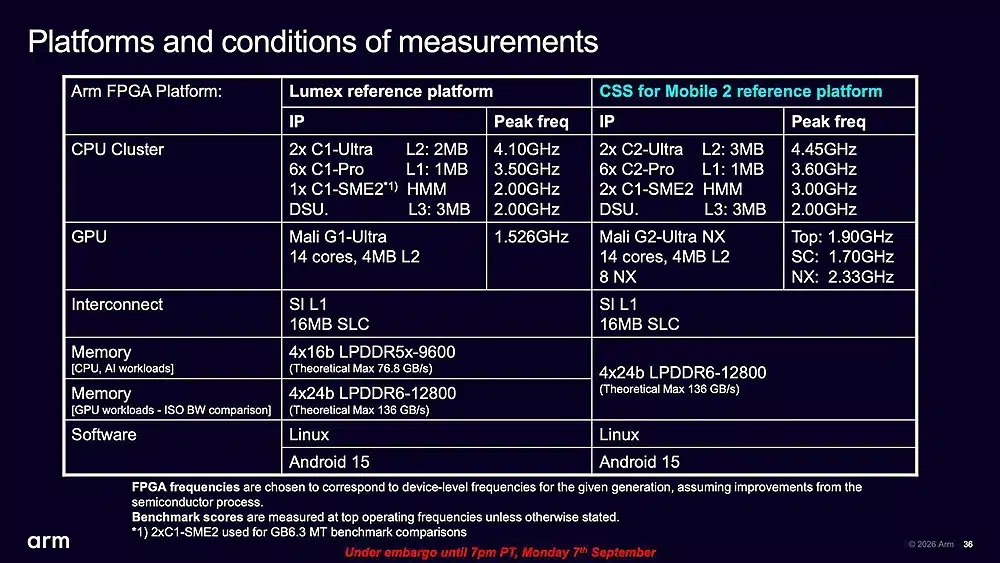
Aquí toca poner las cifras en contexto. La tabla de condiciones compara los C1-Ultra a 4,10 GHz con los C2-Ultra a 4,45 GHz, una subida de frecuencia aproximada del 8,5%. Los Pro, por su parte, pasan de 3,50 a 3,60 GHz. Por tanto, no podemos atribuir toda la mejora a la microarquitectura ni hablar de un aumento equivalente del IPC.
También cambia la aceleración matricial. La referencia anterior enumera un bloque C1-SME2 a 2 GHz, frente a dos bloques C1-SME2 a 3 GHz en la nueva, con una excepción indicada para Geekbench 6.3 multihilo, donde la anterior también utiliza dos. Es otro motivo para leer cada comparación con sus condiciones
Y hay más: en las pruebas de CPU e Inteligencia Artificial se pasa de LPDDR5X-9600 a LPDDR6-12800, con máximos de ancho de banda indicados de 76,8 y 136 GB/s, respectivamente. En las pruebas gráficas, en cambio, ambas referencias utilizan LPDDR6 con el mismo ancho de banda.
Todo ello se presenta como mediciones sobre plataformas FPGA, con frecuencias elegidas para representar los dispositivos previstos y asumiendo mejoras del proceso de fabricación. Es decir, los 4,45 GHz no son una frecuencia garantizada para los futuros móviles, ni estamos ante pruebas independientes de un SoC comercial. Las cifras sirven para conocer la propuesta de Arm, pero describen el conjunto de sus referencias.
SME2 y LUTi: modelos de 2 bits y una CPU que coordina los agentes
En Inteligencia Artificial, Arm anuncia hasta 1,7 veces el rendimiento en determinados modelos utilizando SME2, sus extensiones de cálculo matricial. La compañía quiere que la CPU coordine los agentes: ejecutar código, acceder a datos y organizar las tareas entre los distintos recursos del dispositivo. Para facilitarlo, el software incluye KleidiAI y AI Portal, que permite localizar modelos y recursos optimizados.
Lo de “coordinar” tiene aquí bastante importancia. Arm divide el proceso en percibir, recordar, razonar y actuar. La CPU puede ejecutar modelos ligeros y llamadas a herramientas, mientras distribuye otras cargas entre la GPU, aceleradores especializados y servicios en la nube. Por tanto, no está diciendo que todo deba ejecutarse exclusivamente en la CPU ni que cualquier agente funcione completamente en local.
El ejemplo utilizado consiste en organizar una cena de aniversario: interpretar la petición, consultar la fecha, recuperar preferencias, buscar restaurantes y completar la acción. En ese flujo, Arm muestra una reducción de aproximadamente 280 ms con dos C2-Ultra, que aumenta hasta unos 450 ms al utilizar SME2. Esto equivale aproximadamente a un 15% y un 24% menos de tiempo, respectivamente, frente a la referencia con dos C1-Ultra.
En tareas concretas, las gráficas muestran alrededor de un 40% menos de tiempo en voz a texto, con Moonshine y Parakeet, y un 41% menos en recuperación y búsqueda, con LFM2.5-Colbert-350M. Ojo, hablamos de reducciones temporales: no debemos confundirlas con porcentajes idénticos de aumento del rendimiento ni sumarlas entre sí.
Otra parte que merece atención son las instrucciones LUTi, que trabajan con consultas de tablas para reducir accesos a memoria en determinadas cargas. Combinadas con las capacidades de SME2, permiten aprovechar modelos de muy baja precisión. En los ejemplos mostrados, pasar de INT4 a 2 bits ofrece 1,76 veces el rendimiento al procesar el prompt y 1,60 veces al generar texto. Nuevamente, son comparaciones concretas de ejecución y precisión, no mejoras universales de las CPU C2.
Para aterrizarlo, Arm muestra una demostración de traducción local de inglés a chino mediante Compute Flow. La transcripción, traducción y generación de voz se ejecutan de forma concurrente en CPU. El modelo de traducción utiliza 2 bits y ocupa 300 MB, mientras que la generación de voz trabaja con FP32. La propuesta consiste precisamente en combinar modelos especializados y diferentes precisiones según lo que necesita cada tarea.
SI L2 reduce la latencia de memoria y prepara la plataforma para LPDDR6
La interconexión SI L2 tampoco es un acompañante sin más. Arm la plantea para mover datos entre CPU, GPU y memoria unificada con menor latencia, soporte para el ancho de banda de LPDDR6 y coherencia por hardware. Añade funciones avanzadas de calidad de servicio, una implementación eficiente de MTE y soporte para DVM, además de buscar una menor ocupación de silicio y consumo.
La cifra más llamativa es una reducción aproximada del 45% en la latencia medida en ciclos entre CPU y DRAM frente a SI L1, en la comparación mostrada. Reducir esa espera resulta relevante para cargas que acceden continuamente a modelos, contexto y otros datos.
Eso sí, hay un detalle que no conviene esconder: la tabla de condiciones de rendimiento enumera SI L1 en ambas plataformas de referencia, mientras que los diagramas de CSS for Mobile 2 incluyen SI L2. Por tanto, no podemos dar por hecho que todas las cifras anteriores incorporan también ese recorte de latencia.
Una nueva GPU con aceleración neuronal y Ray Tracing
Por su parte, la Mali G2-Ultra NX incorpora aceleradores neuronales integrados junto al hardware de ejecución de Shaders, un nuevo motor de ejecución y una unidad de Ray Tracing de tercera generación. Arm habla de su mayor reorganización de la ISA gráfica en siete generaciones, orientada también a tecnologías como Nanite y Lumen de Unreal Engine 5.
La configuración de referencia incluye 14 núcleos de GPU, 4 MB de caché L2 y ocho aceleradores NX. Esto es relevante porque no hay un acelerador neuronal por cada núcleo en ese diseño. También existen diferentes frecuencias por dominio: la tabla indica 1,90 GHz para Top, 1,70 GHz para SC y 2,33 GHz para NX, frente a los 1,526 GHz de la Mali G1-Ultra utilizada como referencia.
Arm promete hasta un 14% más de rendimiento en contenido gráfico tradicional. Al combinar la nueva GPU con sus tecnologías neuronales, anuncia hasta cuatro veces el rendimiento por vatio en gráficos neuronales. Son métricas diferentes: ese 4× no significa que cualquier juego vaya a cuadruplicar sus FPS. La compañía también sitúa el objetivo de sus aceleradores en posibilitar gráficos neuronales con un presupuesto de 1 W, sin que ello deba confundirse con el consumo de todo el SoC.
Aquí conviene separar las piezas, porque puede ser un poco caos al principio con tanto nombre y segmentación. La GPU y sus aceleradores son el hardware; NSS, NFRU y NSSD son las tecnologías gráficas que lo aprovechan, es decir, el software.
NSS permite reescalar la imagen, con ejemplos como reconstruir una salida de 1080p desde 540p. NFRU genera fotogramas adicionales, ilustrando el paso de 30 a 60 FPS. Por último, NSSD combina reescalado con eliminación de ruido para gráficos con trazado de rayos, reduciendo la necesidad de calcular tantos rayos para obtener una imagen utilizable.
Muy similar a lo que hemos visto con Intel, AMD y NVIDIA, por ejemplo. Por tanto, sí, es lo que estás pensando: hay funciones comparables a las de DLSS, pero llamarlo directamente «DLSS 5 para móviles» como se está vendiendo desde algunos medios simplifica demasiado el anuncio. Además, estas capacidades necesitan integración mediante las herramientas y tecnologías gráficas de Arm; no basta con incorporar la GPU para que aparezcan automáticamente en todos los juegos.
Neoverse CSS N4 lleva la ofensiva a los servidores con hasta 128 núcleos por die
Finalmente, Neoverse CSS N4 «Ranger» lleva esta renovación a servidores con hasta 128 núcleos por die, soporte para LPDDR6 y PCIe 7.0. De nuevo, hablamos de una base configurable para que los socios desarrollen sus chips, ajustándolos a sus necesidades de computación, conectividad y movimiento de datos.
Frente a CSS N3, Arm promete hasta el doble de rendimiento, 1,25 veces el rendimiento por vatio y 1,75 veces el ancho de banda de memoria. Su objetivo abarca infraestructura cloud, procesamiento de datos y coordinación de aceleradores, donde importa tanto la capacidad de cálculo como alimentar los núcleos y comunicar los distintos componentes. Son cifras del fabricante: habrá que ver cómo se trasladan a los chips comerciales que desarrollen sus socios.
Dicho todo, el despliegue es amplio y sus socios dispondrán de más recursos para competir en móviles y servidores. Pero hay que separar esta renovación de diseños y plataformas de la estrategia de silicio propio de Arm. Estos anuncios no confirman que vaya a vender bajo su marca un SoC móvil con C2 y Mali, ni permiten anticipar qué productos adicionales lanzará. Lo que sí dejan claro es que su apuesta ya no se limita a mejorar una CPU: quiere intervenir en cómo se diseña, conecta y programa el conjunto del sistema. Tras lo visto en su CPU AGI, ¿qué nos traerán este año y en 2027? No lo sabemos, pero vista la arquitectura previa, pinta realmente muy bien.